语义搜索(语义检索)是一种不看输入字符串是否一致、而是按文本「含义的接近程度」来查找信息的检索技术。 即便文档里写的是「年休」,用「带薪年假」这个说法也能找到,因此对表述不一致和说法差异有很强的适应力,能大幅提升企业文档的检索准确度。
本文用一篇的篇幅,把「先用图解理解原理」和**「在自家公司的文档上真正跑一遍」**这两件事一次做完。不需要编程知识。包含准备文档在内,大约需要 30 分钟到 1 小时。
30秒讲清语义搜索的原理
语义搜索大体分为以下三步。
- 把含义转成数值(向量化) —— AI 读取文本,把「这句话是什么意思」转换成一串数值(向量)。含义相近的文本,数值也会相近。
- 测量含义的接近程度 —— 提问也用同样方式转成数值,再与文档侧的数值比较,挑出「含义相近」的内容。字面不一致也没关系,只要含义相近就会被选中。
- 返回答案 —— 把选中的部分直接呈现,或者由生成式AI以此为依据,用自然的语言作答。
如果说关键词检索是「找字面相同的内容」,那么语义搜索就是「找想说的意思相同的内容」,这样理解会更清楚。
本文要点
- 什么是语义搜索(语义检索),它的原理是什么
- 为什么关键词检索找不到企业文档
- 语义搜索与关键词检索的区别(对比表)
- 【教程】在企业文档上实际试用的步骤(准备·投入·测试·改进)
- 答不好时的原因与修正方法(诊断表)
- 2026年时点 AI 检索的走向(不再只依赖向量检索)
- Monoshiri AI 如何实现「按含义查找」(沿技能树导航的方式)
为什么关键词检索找不到
共享文件夹和文件服务器自带的传统检索功能,是查找与输入字符串完全一致的词的「关键词检索」。
这种方式存在根本性的极限。比如想知道怎么请年假,在检索框输入「带薪年假」,但文档里写的是「年休」或「年度休假」,就不会命中。人一看就知道是一回事,但关键词检索只看字面是否一致。
结果就是这些问题反复出现:
- 反复更换检索词去试
- 找不到,最后还是去问「懂行的人」
- 甚至不知道到底有没有这份文档
据 McKinsey Global Institute 的调查,知识工作者约有 20% 的工作时间花在查找信息上。这其中很大一部分,消耗在了「找不到的检索」上。
如果想更细致地区分失败类型,可以参考企业文档搜不到?关键词检索失效的 7 个原因与对策,文中分成了七类。
什么是语义搜索 —— 按「含义的接近程度」查找
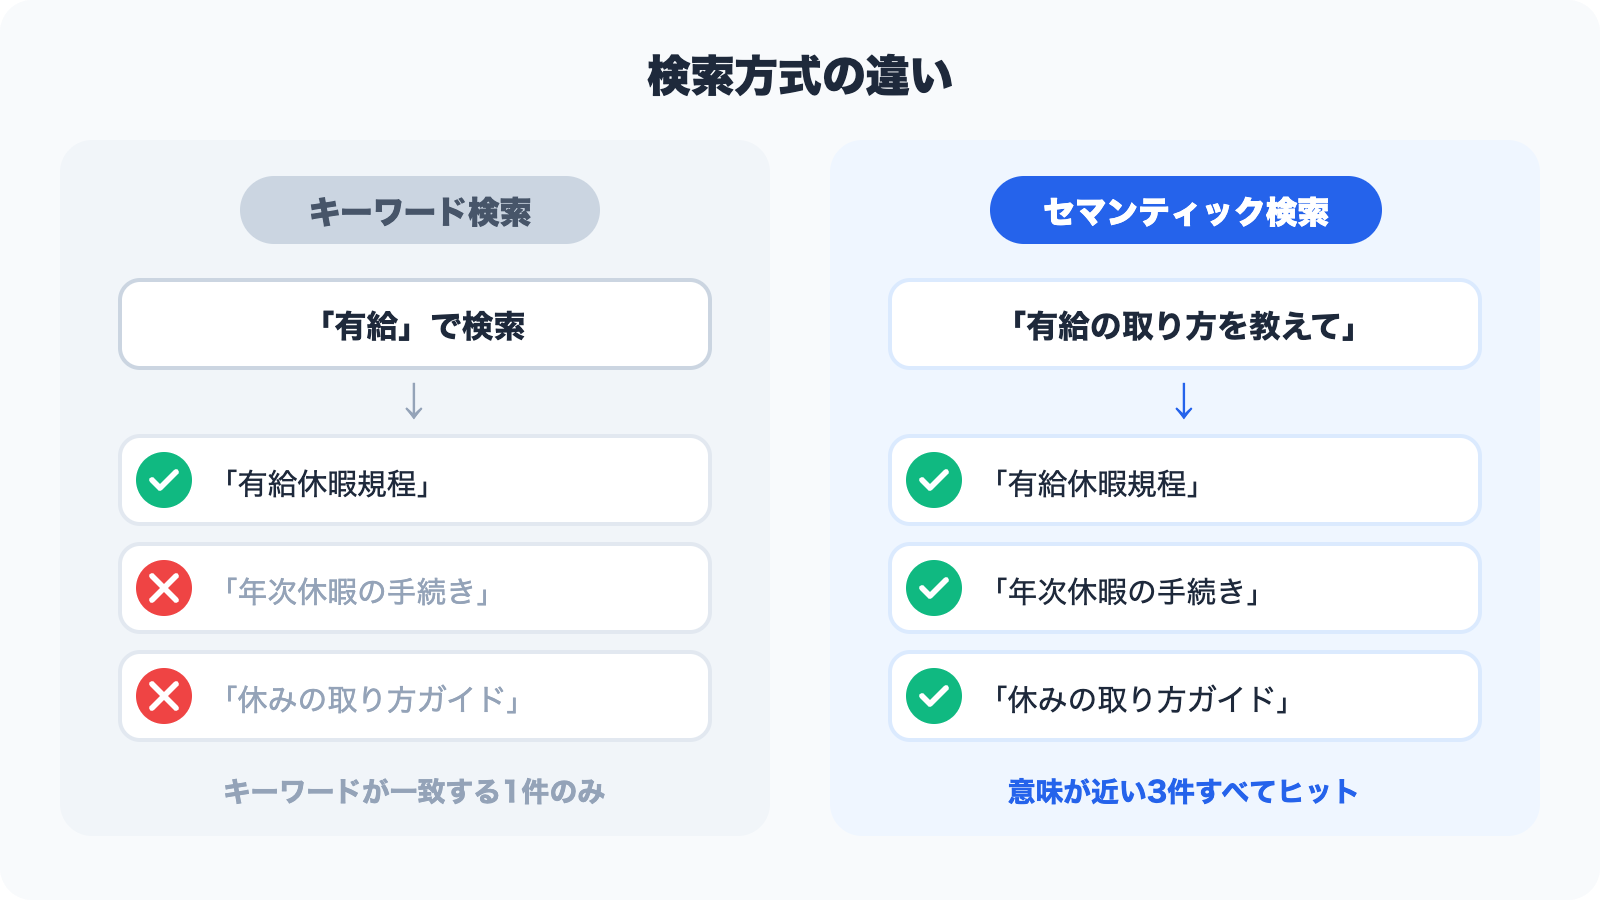
语义搜索不是按关键词是否一致,而是按文本「含义」的接近程度来查找信息的检索技术。
关键在于,AI 不是拿词本身、而是拿词背后的「含义」作为线索去找。AI 从海量文本中学习了词语的用法,因此即便「年休」和「带薪年假」写法不同,也能判断它们指的是同一件事。所以哪怕输入的词与文档里的词一字不差地对不上,也能找出符合意图的文档。
有了这套机制,下面这些提问都会指向同一份文档。
| 提问的说法 | 想找的内容 |
|---|---|
| 「带薪年假怎么申请?」 | 请假手续 |
| 「年休怎么休?」 | 请假手续 |
| 「想知道怎么请假」 | 请假手续 |
在关键词检索看来这是三个不同的查询,而在语义搜索看来,它们都被理解为同一个「含义」。
关键词检索 vs 语义搜索 对比
| 对比项 | 关键词检索 | 语义搜索 |
|---|---|---|
| 检索机制 | 字符串完全匹配/部分匹配 | 文本含义的接近程度 |
| 表述不一致 | 无法应对 | 自动应对 |
| 自然语句检索 | 不擅长 | 擅长 |
| 结果准确度 | 取决于关键词 | 理解意图后返回 |
| 专业术语 | 需要准确的术语 | 用通俗说法也能命中 |
| 擅长场景 | 型号、条款编号等「就找这串字符」时 | 找「这一类内容」时 |
需要注意的是,语义搜索并非关键词检索的完全上位替代。像「型号 AB-2201-J 的规格书」这样字符串本身就是线索的检索,关键词检索更可靠。实务中两者并用才现实。
【教程】在企业文档上试用语义搜索
下面才是重点。只读原理,无法判断在自家文档上是否真的好用。这里按顺序走一遍,用手头的文档做出一个能按含义检索的状态。
以下以 Monoshiri AI 的免费方案为例,但思路在其他 AI 知识库上同样适用。
步骤0:准备试用的文档和问题(约10分钟)
第一件事不是去摸工具,而是先定题材。跳过这一步,最后只会停留在「好像能用吧」的模糊感受上。
需要准备两样东西。
(1) 挑选 5 到 20 份文档
不要一上来就把全公司的文档都放进去。从符合以下条件的文档入手,更容易判断效果。
- 咨询量大的主题(费用报销、请假、入职手续、常见产品问题等)
- 内容当前有效的(不要混入旧版、待作废的版本)
- PDF、Word、Excel、PowerPoint 等平时在用的格式,原样即可
(2) 写出 10 个测试问题
把员工实际问过的问题,按原话写下来。诀窍是混合以下三类。
| 类型 | 目的 | 示例 |
|---|---|---|
| 表述不一致型 | 能否用与文档不同的说法提问 | 文档写「年休」→ 问「带薪年假有几天?」 |
| 自然语句型 | 口语原样能否听懂 | 「出差坐高铁的票钱是不是要先自己垫?」 |
| 复合型 | 能否跨多份文档 | 「社招入职第一年有几天年假,申请要交给谁?」 |
与关键词检索拉开差距的,压倒性地集中在表述不一致型和自然语句型。这 10 个问题后面评估还要原样使用,请记录下来。
步骤1:上传文档(约5分钟)
上传准备好的文档。不需要重做既有的手册和规章制度,也不需要为 AI 改写。先把现有的东西原样放进去。
此时按「人事」「财务」这样的主题分好文件夹,之后就能按部门设置访问范围。关于文件夹级别的管理,功能一览页面有详细介绍。
步骤2:等待 AI 整理内容(约5〜15分钟)
上传的文档会由 AI 自动读取,并按内容归类整理。对 Monoshiri AI 而言,技能树(给AI用的目录)会在这一步自动构建。
不需要像传统聊天机器人那样,一条条登记「问答对」。这一步人要做的,只有等待。
步骤3:把准备好的10个问题实际问一遍(约10分钟)
准备就绪后,从管理后台、LINE 或嵌入网站的聊天挂件提问。把步骤0写好的 10 个问题,不要改写,按原话投进去。
同时对每一题记录下面三点。
- 回答是否正确(○ / △ / ×)
- 作为依据给出的引用文档,是否是预期的那一份
- 若与预期不符,本应去查哪份文档
10 题中有 7 题以上为○,该领域就达到了可以投入实际使用的水平。这些记录会成为下一步的素材。
步骤4:修正答错的问题(约10分钟)
语义搜索不是「放进去就结束」。不过要改的通常不是检索引擎的设置,多数情况下是文档一侧。常见原因与对策整理成诊断表如下。
| 症状 | 常见原因 | 对策 |
|---|---|---|
| 回答「没有相关内容」 | 根本没有写这件事的文档 | 把只靠口头传达的内容写成一页文档 |
| 返回过时信息 | 旧版和新版都放了进去 | 删除旧版(AI 无法判断「哪个更新」) |
| 混入其他部门的内容 | 文件夹划分太粗 | 按主题、按部门分开文件夹 |
| 内容没错但回答含糊 | 文档只有零散的要点,没写前提 | 在各章节开头补上标题和 1〜2 句摘要 |
| 表格、扫描版 PDF 的内容取不到 | 以图片形式保存的文字读不出来 | 重新导出为带文本层的 PDF,或把表格誊写进正文 |
关于面向 AI 的文档写法,怎样写出AI答得好的知识文档有更详细的解说。
步骤5:扩大范围
10 个问题的准确度稳定后,再逐个增加文件夹。比起一开始就投入全公司文档,按主题一点点积累「确实好用」的体验,更容易赢得内部认可,这是实务上的诀窍。
部署初期的推进方式,整理在知识库部署 最初的30天一文中。
Monoshiri AI 如何「按含义查找」—— 沿技能树导航的机制
教程的步骤2里写了「AI 整理内容」。这里再具体看看那时到底发生了什么。
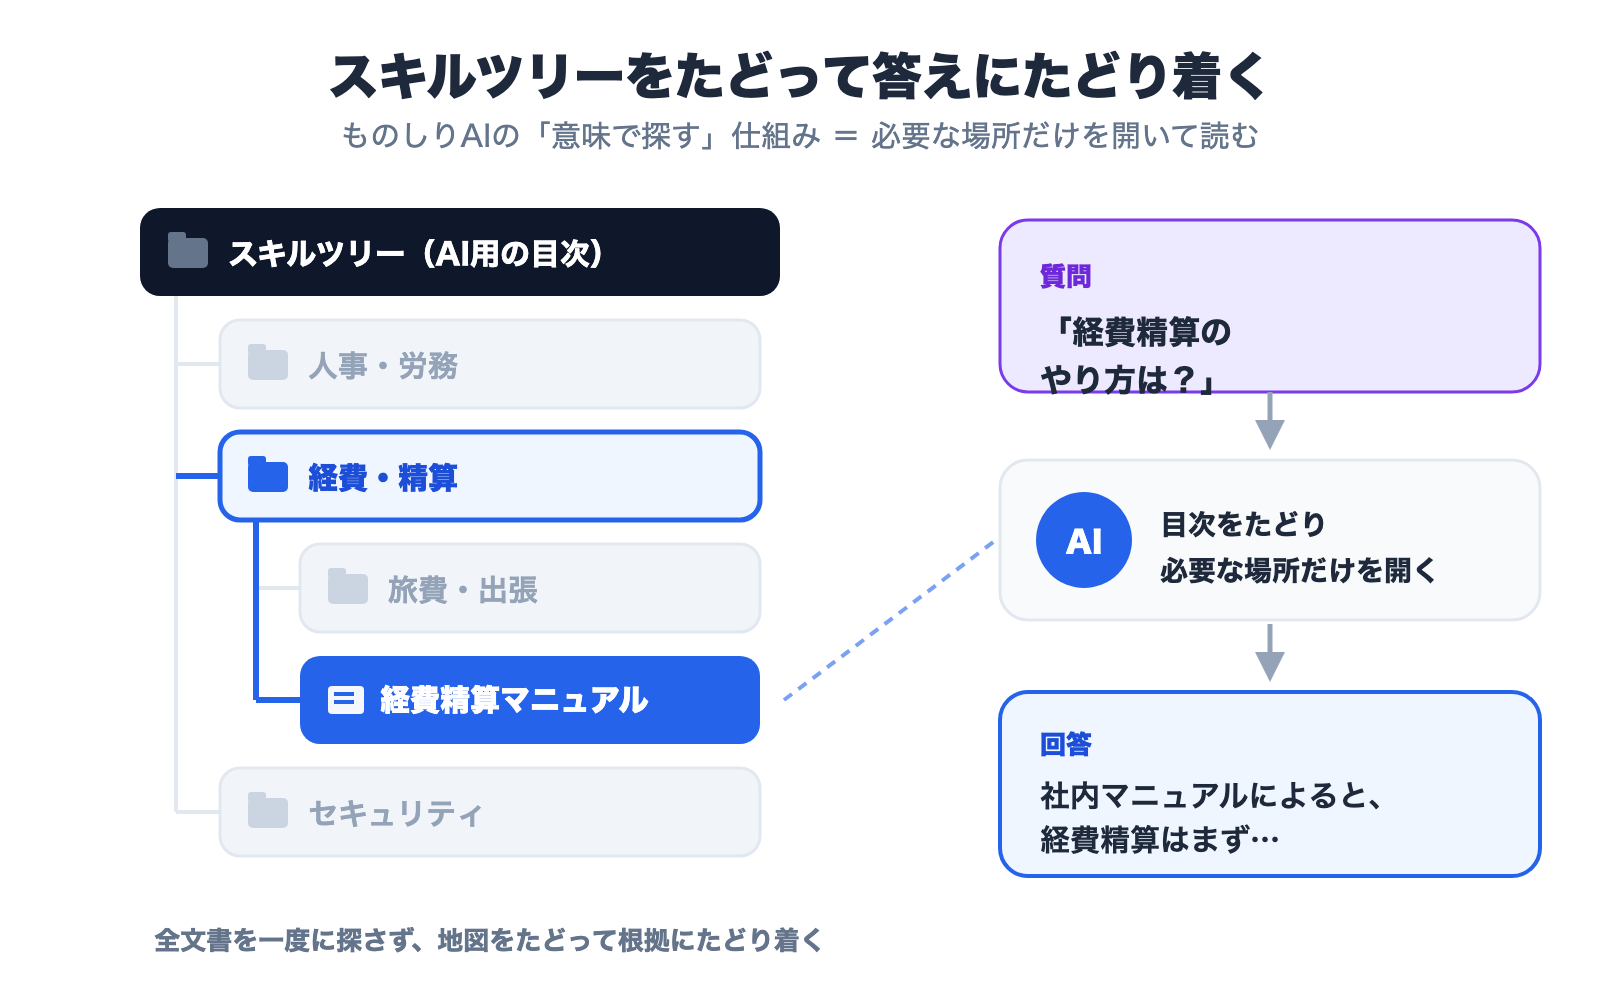
关键在于技能树(skill tree)这一思路。可以把技能树理解为一份类似文件夹结构的目录,它把企业文档整理成便于AI使用的形式。
事前准备:把知识整理成「技能地图」
上传文档后,Monoshiri AI 会先读取全部文档,按内容的归类自动生成分层目录(技能树)。可以想象成:从「人事」「财务」「安全」这类大主题,向下分叉到更细的小主题,形成一份像书的目录或共享文件夹那样的「技能地图」。
这张地图不是每次提问都做,而是在上传时只做一次。
回答时:AI 只打开需要的位置去读
用户提问时,AI 会从上往下沿着这张地图导航。看目录选出可能相关的主题,再往里看,只打开需要的页面来读 —— 这与人从厚厚的手册中找答案的动作非常相似。
也就是说,Monoshiri AI 不是把全部文档一并检索,而是靠地图判断「看这里就行」,只打开必要的位置。因为不会打开无关的地方,所以依据明确,也不容易被无关信息干扰。
教程步骤3之所以请你确认「作为依据给出的引用文档」,正是为了让人能检查这条路径是否合理。
什么是RAG?—— 用生成式AI检索企业文档的代表性方法
用生成式AI检索企业文档的方法中,广为人知的是 RAG(Retrieval-Augmented Generation:检索增强生成)。这是 Meta AI Research 于 2020 年提出的方法,被许多 AI 服务采用。
RAG 大致分两步运作。
- 检索(Retrieval):从企业文档中收集与提问相关的文档
- 生成(Generation):基于收集到的内容,由生成式AI用自然的语言作答
关键在于,AI 不是依据「自己的知识」,而是依据「企业文档的内容」来回答。这样可以抑制通用 AI 聊天中常见的「看似合理但与事实不符的回答(幻觉)」。例如提问「出差交通费怎么报销?」,AI 会从公司的费用报销手册中找到对应段落,像「根据公司规定,出差交通费……」这样给出依据后作答。
语义搜索长期以来被广泛用作 RAG 中「检索」一侧的技术。
到2026年,语义搜索的定位发生了什么变化
2020年代前半,说到企业文档的AI检索,几乎只有一个答案:把文档切成小块、向量化后放入专用数据库,每次提问都取出最接近的若干块。到 2026 年,这个前提在三个方面发生了变化。
1. 模型一次能读的量大幅增加
主流 LLM 能处理的上下文长度逐年增长,「拼命只收集看起来相关的片段」的必要性比过去下降了。像一本规章制度那样的体量,整体喂给模型反而准确度更高的场景也存在。详细比较请见RAG已经过时了吗?长上下文时代的知识库设计。
2. 关注点从「检索」转向「查找方式的设计」
近年来,设计「把什么、按什么顺序交给AI」的**上下文工程(context engineering)**这一思路正在扩散。因为即便是同一批文档,交付方式不同,回答质量也会不同。只是把相似度最高的前 N 个片段交上去的做法,其弱点已被广泛认识:依据变得零散,上下文被切断。
3. 让AI自己去找的方式进入实用阶段
不止于一次检索,而是让 AI 看目录、需要时深挖、不够时再去别处查 —— 这类导航型方式已经实用化。Monoshiri AI 的技能树也属于这一脉络。
结论是,2026年该讨论的不是「要不要用向量检索」,而是「怎样把企业文档呈现给AI」。 语义搜索本身的价值 —— 对表述不一致有韧性、能用自然语句提问 —— 并没有改变。改变的是,实现手段不再只有一种。
思路的梳理在「不需要RAG论」是真的吗?企业知识AI的6条判断轴中也有涉及。
常见问题
Q. 部署语义搜索需要工程师吗?
使用 SaaS 型 AI 知识库的话不需要。本文的教程只靠上传文件和提问就能完成。自行搭建则需要工程能力。
Q. 文档大约要多少份才有效果?
比起数量,更重要的是「是否覆盖了咨询集中的主题」。哪怕只有 5〜20 份,只要落在咨询量大的领域,效果就能体感到。
Q. 与既有的聊天机器人有什么不同?
传统聊天机器人需要事先设计「场景」,无法应对预设之外的问题。基于语义搜索的AI检索直接参考文档内容,无需场景设计,能够应对更广泛的问题。详情请参阅服务对比页面。
Q. 把企业文档放到云上不太放心。
请确认是否标准提供数据加密、访问控制,以及按组织隔离数据。Monoshiri AI 的覆盖范围记载在安全页面。
Q. 费用大概多少?
以月费制服务为主流。稳妥的做法是先用免费方案跑一遍本文的教程,确认效果后再考虑付费方案。具体价格请查看定价方案页面。
总结
本文讲解了语义搜索的原理,以及在企业文档上实际试用的步骤。
- 什么是语义搜索:不看字面是否一致,而按文本「含义的接近程度」查找信息的检索技术
- 原理:把含义转成数值,测量与提问的接近程度,再基于依据作答
- 与关键词检索的分工:型号、条款编号用关键词检索,「这一类内容」用语义搜索
- 怎么试:准备 5〜20 份文档和 10 个测试问题,把投入·提问·记录·修正跑完一轮
- 答错时该改的是文档一侧:删除旧版、拆分文件夹、补写摘要,大半问题都能改善
- 2026年的关键议题:不是要不要用向量检索,而是怎样把企业文档呈现给AI
企业文档「明明有却找不到」的状态,正在悄悄侵蚀日常的生产力。先从咨询量最大的一个主题开始,确认查找时间是否真的减少了。
相关文章
分享这篇文章
相关文章
如何为 STUDIO 网站添加聊天机器人|自定义代码嵌入步骤【2026年版】
按实际设置界面讲解如何在 STUDIO 搭建的网站上安装 AI 聊天机器人。包括为什么必须付费套餐、为什么预览里看不到,以及为什么不能用嵌入框(Embed)。
如何为 Wix 网站添加聊天机器人|自定义代码嵌入步骤【2026年版】
按实际后台界面讲解如何在 Wix 网站上安装 AI 聊天机器人。包括为什么必须先连接域名、更换域名会删除代码片段的规格,以及与内置聊天的区别。
如何为 Shopify 添加聊天机器人|无需应用的自定义 Liquid 安装法【2026年版】
对比 Shopify 接入聊天机器人的三种方式,并详解无需安装应用的「自定义 Liquid」步骤。同时说明更换主题会悄悄失效的陷阱、结账页无法显示的规格,以及免费套餐的边界。