セマンティック検索(意味検索)とは、入力した文字列の一致ではなく、文章の「意味の近さ」で情報を探す検索技術です。 「年次休暇」と書かれた文書を「有給休暇」という言葉でも見つけられるため、表記ゆれや言い回しの違いに強く、社内文書の検索精度を大きく高めます。
本記事は、この仕組みを図解で理解したうえで、自分の会社の文書で実際に動かしてみるところまでを1本で完結させるチュートリアルです。プログラミングの知識は必要ありません。所要時間は、文書の準備を含めておよそ30分から1時間です。
セマンティック検索の仕組みを30秒で
セマンティック検索は、大きく次の3ステップで動きます。
- 意味を数値に変換する(ベクトル化) -- AIが文章を読み、「この文はどういう意味か」を数値の並び(ベクトル)に変換します。意味が近い文章どうしは、近い数値になります。
- 意味の近さを測る -- 質問文も同じように数値に変換し、文書側の数値と比べて「意味が近いもの」を選び出します。文字が一致していなくても、意味が近ければ選ばれます。
- 答えを返す -- 選ばれた箇所をそのまま提示するか、生成AIがそれを根拠に自然な文章で回答します。
キーワード検索が「文字が同じものを探す」のに対し、セマンティック検索は「言いたいことが同じものを探す」と考えると分かりやすいでしょう。
この記事で分かること
- セマンティック検索(意味検索)とは何か、その仕組み
- キーワード検索で社内文書が見つからない理由
- セマンティック検索とキーワード検索の違い(比較表)
- 【チュートリアル】社内文書で実際に試す手順(準備・投入・テスト・改善)
- うまく答えられないときの原因と直し方(診断表)
- 2026年時点でのAI検索の潮流(ベクトル検索一辺倒からの変化)
- ものしりAIが「意味で探す」を実現する仕組み(スキルツリーをたどる方式)
なぜキーワード検索では見つからないのか
共有フォルダやファイルサーバーに搭載されている従来の検索機能は、入力された文字列と完全に一致する単語を探す「キーワード検索」 です。
この方式には根本的な限界があります。たとえば、有給休暇の取り方を知りたいとき、検索窓に「有給休暇」と入力しても、ドキュメント内に書かれているのが「年次休暇」や「年休」であればヒットしません。人間なら同じ意味だと分かりますが、キーワード検索は文字の一致しか見ていないからです。
結果として、次のような問題が繰り返されます。
- 検索キーワードを何度も変えて試す
- 見つからないので結局「詳しい人」に聞きに行く
- そもそもドキュメントが存在するかどうかも分からない
McKinsey Global Instituteの調査によれば、ナレッジワーカーは勤務時間の約20%を情報検索に費やしているとされています。この時間の多くは「見つからない検索」に消えています。
失敗のパターンをより細かく切り分けたい場合は、キーワード検索で社内ドキュメントが活用できない限界で7つの類型に分けて解説しています。
セマンティック検索とは -- 「意味の近さ」で探す
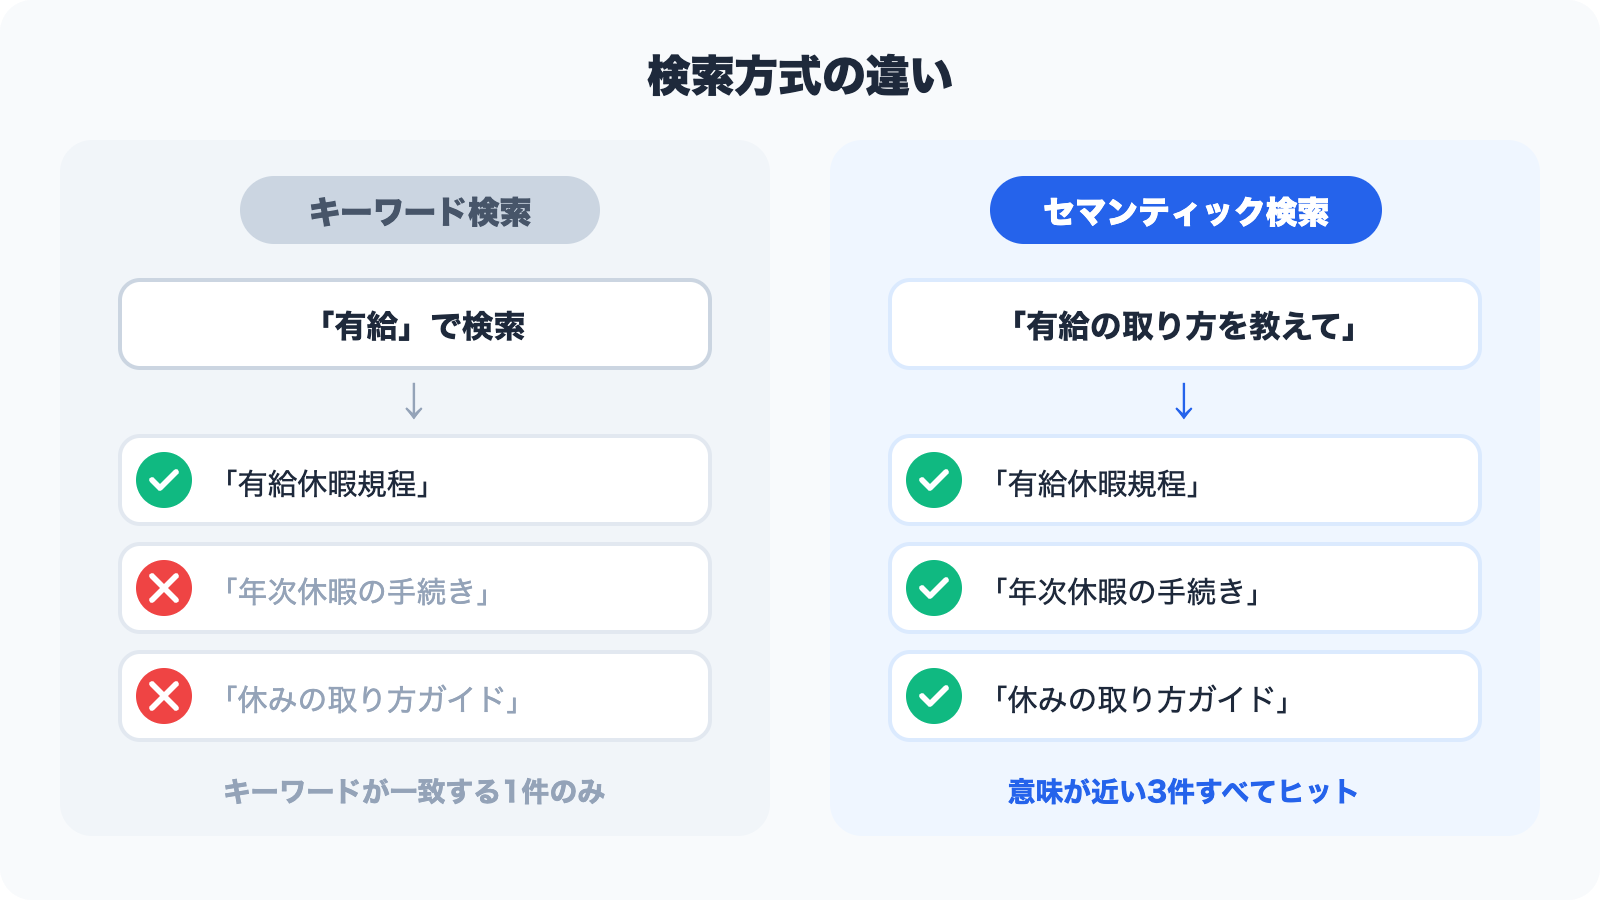
セマンティック検索(意味検索)は、キーワードの一致ではなく、文章の「意味」の近さで情報を探す検索技術です。
ポイントは、AIが言葉そのものではなく、その背後にある「意味」を手がかりに探すことです。AIは膨大な文章から言葉の使われ方を学んでいるため、「年次休暇」と「有給休暇」のように表記が違っても、同じことを指していると判断できます。だから、入力した言葉とドキュメント内の言葉が一字一句一致しなくても、意図に合った文書を見つけ出せるのです。
この仕組みにより、たとえば次のような質問がすべて同じドキュメントにたどり着きます。
| 質問の表現 | 探したい内容 |
|---|---|
| 「有給休暇の申請方法を教えて」 | 休暇の取得手続き |
| 「年次休暇の取り方は?」 | 休暇の取得手続き |
| 「休みの取り方を知りたい」 | 休暇の取得手続き |
キーワード検索では3つの異なるクエリですが、セマンティック検索ではすべて同じ「意味」として理解されます。
キーワード検索 vs セマンティック検索の比較
| 比較項目 | キーワード検索 | セマンティック検索 |
|---|---|---|
| 検索の仕組み | 文字列の完全一致/部分一致 | 文章の意味の近さ |
| 表記ゆれへの対応 | 対応できない | 自動的に対応 |
| 自然文での検索 | 苦手 | 得意 |
| 検索結果の精度 | キーワード次第 | 意図を理解して返す |
| 専門用語への対応 | 正確な用語が必要 | 平易な言い回しでもヒット |
| 得意な場面 | 型番・条文番号など「その文字列」を探すとき | 「こういう内容」を探すとき |
なお、セマンティック検索はキーワード検索の上位互換ではありません。「型番 AB-2201-J の仕様書」のように文字列そのものが手がかりになる検索は、キーワード検索の方が確実です。実務では両方を併用するのが現実的です。
【チュートリアル】社内文書でセマンティック検索を試す
ここからが本題です。仕組みを読むだけでは、自社の文書で本当に使えるかは分かりません。手元の文書を使って、実際に意味検索できる状態を作るまでを順に進めます。
以下はものしりAIの無料プランを例にした手順ですが、考え方は他のAIナレッジベースでも共通です。
ステップ0: 試す文書と質問を用意する(所要10分)
最初にやることは、ツールを触ることではなく題材を決めることです。ここを飛ばすと「なんとなく動いた気がする」で終わってしまいます。
用意するものは2つです。
(1) 文書を5〜20ファイル選ぶ
いきなり全社の文書を入れないでください。次の条件に当てはまるものから選ぶと、効果を判断しやすくなります。
- 問い合わせが多いテーマ(経費精算、休暇、入社手続き、よくある製品質問など)
- 内容が現行で正しいもの(古い版・破棄予定のものは混ぜない)
- PDF・Word・Excel・PowerPointなど、普段使っている形式のまま
(2) テスト質問を10問つくる
実際に社員から聞かれた質問を、そのままの言葉で書き出します。このとき、次の3種類を混ぜるのがコツです。
| 種類 | 意図 | 例 |
|---|---|---|
| 表記ゆれ型 | 文書と違う言葉で聞けるか | 文書に「年次休暇」→ 質問は「有給って何日もらえる?」 |
| 自然文型 | 会話のままで通じるか | 「出張のとき新幹線代って先に払うんでしたっけ」 |
| 複合型 | 複数文書をまたげるか | 「中途入社の初年度の有給は何日で、申請は誰に出す?」 |
キーワード検索との差が出るのは、圧倒的に表記ゆれ型と自然文型です。この10問は後の評価にそのまま使うので、メモに残しておいてください。
ステップ1: ドキュメントをアップロードする(所要5分)
用意した文書をアップロードします。既存のマニュアルや規程集を作り直したり、AI向けに書き換えたりする必要はありません。まずはあるものをそのまま入れてください。
このとき、フォルダを「人事」「経費」のようにテーマごとに分けておくと、後で部署ごとにアクセス範囲を設定できます。フォルダ単位の管理については機能一覧ページで詳しく紹介しています。
ステップ2: AIが内容を整理するのを待つ(所要5〜15分)
アップロードされたドキュメントは、AIが自動的に読み取り、内容のまとまりごとに整理します。ものしりAIの場合は、ここでスキルツリー(AI用の目次)が自動で構築されます。
従来のチャットボットのように「質問と回答のペア」を1つずつ登録する作業はありません。この工程で人がやることは、待つことだけです。
ステップ3: 用意した10問を実際に聞く(所要10分)
準備ができたら、管理画面やLINE、Webサイトに埋め込んだチャットウィジェットから質問します。ステップ0で作った10問を、言い換えずにそのままの言葉で投げてください。
このとき、次の3点を1問ずつ記録します。
- 答えが正しかったか(○ / △ / ×)
- 根拠として示された文書が、想定どおりのものだったか
- 想定と違う場合、どの文書を見に行ってほしかったか
10問中7問以上が○なら、その領域は実運用に載せられる水準です。この記録が、次のステップの材料になります。
ステップ4: 外した質問を直す(所要10分)
セマンティック検索は「入れて終わり」ではありません。ただし、直すのは検索エンジン側の設定ではなく、ほとんどの場合は文書側です。よくある原因と対処を診断表にまとめます。
| 症状 | よくある原因 | 対処 |
|---|---|---|
| 「該当なし」と返ってくる | そもそもその内容を書いた文書がない | 口頭で運用していた内容を1ページで文書化する |
| 古い情報が返ってくる | 旧版と新版の両方が入っている | 旧版を削除する(AIは「どちらが新しいか」を判断できない) |
| 別部署の内容が混ざる | フォルダ分けが粗い | テーマ別・部署別にフォルダを分ける |
| 内容は合っているが答えが曖昧 | 文書が箇条書きの断片だけで、前提が書かれていない | 見出しと1〜2文の要約を各節の冒頭に足す |
| 表・スキャンPDFの内容を拾えない | 画像として保存された文字を読めていない | テキスト付きPDFで出し直す、または表を本文に書き起こす |
AI向けの文書の書き方については、AIが答えやすいナレッジの書き方でさらに詳しく解説しています。
ステップ5: 対象を広げる
10問の精度が安定したら、フォルダを1つずつ増やしていきます。最初から全社文書を投入するより、テーマ単位で「使えた」を積み重ねる方が、社内の納得を得やすいというのが実務上のコツです。
導入初期の進め方はナレッジベース導入 最初の30日にまとめています。
ものしりAIはどう「意味で探す」のか -- スキルツリーをたどる仕組み
チュートリアルのステップ2で「AIが内容を整理する」と書きました。ここで何が起きているのかを、もう少し具体的に見ておきます。
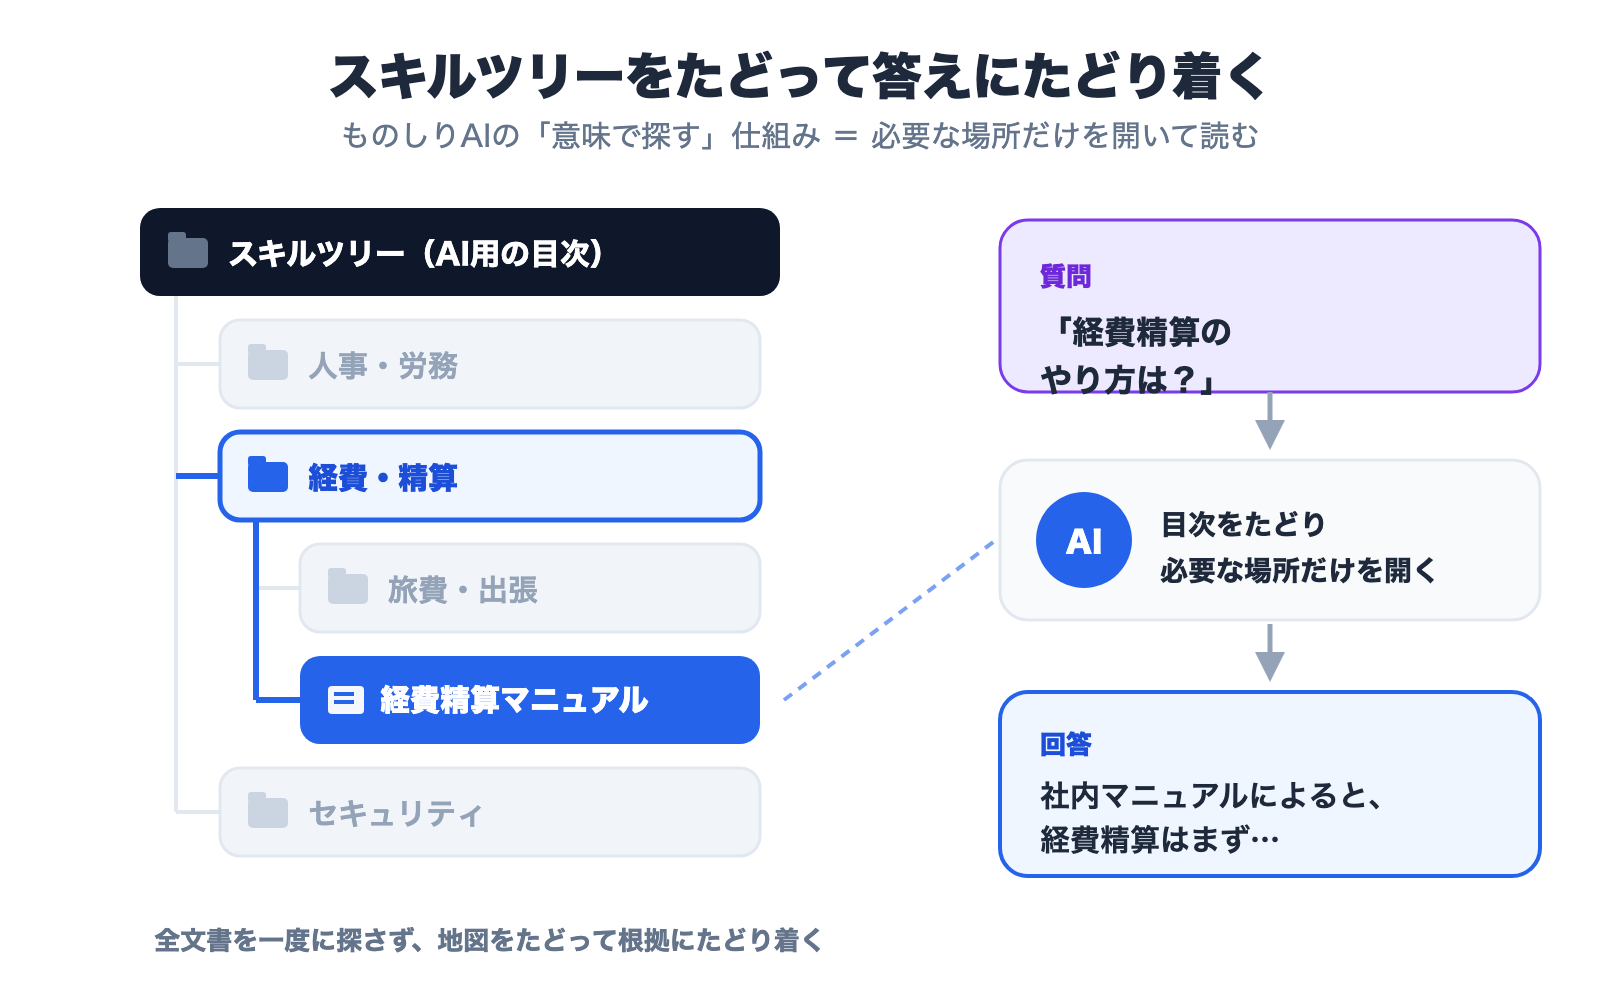
鍵になるのがスキルツリーという考え方です。スキルツリーとは、社内文書をAIが扱いやすいように整理した、フォルダ構造の目次のようなものだと考えてください。
事前準備: ナレッジを「スキルの地図」に整理しておく
文書をアップロードすると、ものしりAIはまず全文書を読み込み、内容のまとまりごとに階層的な目次(スキルツリー)を自動で作成します。「人事」「経費」「セキュリティ」といった大きなテーマから、その下の細かなトピックへと枝分かれする、**本の目次や共有フォルダのような"スキルの地図"**を用意しておくイメージです。
この地図づくりは質問のたびではなく、アップロード時に一度だけ行います。
回答時: AIが必要な場所だけを開いて読みに行く
ユーザーが質問すると、AIはこの地図を**上から順にたどって(ナビゲートして)**いきます。目次を見て関連しそうなテーマを選び、その中をさらに見て、必要なページだけを開いて読む――人が分厚いマニュアルから答えを探すときの動きとよく似ています。
つまりものしりAIは、全文書をまとめて探すのではなく、地図を頼りに「ここを見ればよい」と判断しながら必要な場所だけを開いていくのです。関係のない場所は開かないため、根拠が明確で、無関係な情報に惑わされにくいという利点があります。
チュートリアルのステップ3で「根拠として示された文書」を確認してもらったのは、この経路が妥当かどうかを人がチェックできるようにするためです。
RAGとは? -- 生成AIで社内文書を検索する代表的な方法
生成AIで社内文書を検索する方法として広く知られているのが、RAG(Retrieval-Augmented Generation: 検索拡張生成) です。2020年にMeta AI Researchが提唱した手法で、多くのAIサービスで使われています。
RAGは大きく2つのステップで動きます。
- 検索(Retrieval): 質問に関連しそうなドキュメントを社内文書の中から集める
- 生成(Generation): 集めた内容をもとに、生成AIが自然な文章で回答する
ポイントは、AIが「自分の知識」ではなく「社内文書の内容」を根拠にして回答することです。これにより、一般的なAIチャットで問題になる「もっともらしいが事実と異なる回答(ハルシネーション)」を抑えられます。たとえば「出張時の交通費精算はどうすればいい?」と質問すると、AIは社内の経費精算マニュアルから該当箇所を見つけ出し、「社内規程によると、出張交通費は...」のように根拠を示しながら回答します。
セマンティック検索は、このRAGの「検索」側を担う技術として広く使われてきました。
2026年、セマンティック検索の位置づけはどう変わったか
2020年代前半、社内文書のAI検索といえば「文書を細かく分割し、ベクトル化して専用データベースに入れ、質問のたびに近いものを引く」という構成がほぼ唯一の答えでした。2026年時点では、この前提が3つの点で動いています。
1. モデルが一度に読める量が大幅に増えた
主要なLLMが扱えるコンテキスト長は年々伸び、「関連しそうな断片だけを必死に集める」必要性が以前より下がりました。規程集1冊程度なら、まとめて読ませた方が精度が高い場面もあります。詳しくはRAGはもう古い?長文コンテキスト時代のナレッジベース設計で比較しています。
2. 「検索」から「探し方の設計」へ関心が移った
近年は、何をどの順番でAIに渡すかを設計するコンテキストエンジニアリングという考え方が広がっています。同じ文書群でも、渡し方次第で回答品質が変わるためです。単に類似度の高い断片を上位N件渡す方式は、根拠が飛び飛びになり、文脈が切れるという弱点が知られるようになりました。
3. AIが自分で探しに行く方式が実用段階に入った
一度の検索で終わらせず、AIが目次を見て、必要なら深掘りし、足りなければ別の場所を見に行く――そうしたナビゲーション型の方式が実用化されています。ものしりAIのスキルツリーもこの系統です。
結論として、2026年に検討すべきなのは「ベクトル検索を使うかどうか」ではなく、「AIに社内文書をどう見せるか」です。 表記ゆれに強い、自然文で聞けるというセマンティック検索の価値そのものは変わっていません。変わったのは、その実現手段が1つではなくなったことです。
考え方の整理は「RAG不要論」は本当か?社内ナレッジAIの判断軸6つでも扱っています。
よくある質問
Q. セマンティック検索を導入するのにエンジニアは必要ですか?
SaaSのAIナレッジベースを使う場合は不要です。本記事のチュートリアルは、ファイルのアップロードと質問だけで完結します。自前で構築する場合はエンジニアリングが必要になります。
Q. 文書は何件くらいから効果が出ますか?
件数よりも「問い合わせが集中しているテーマをカバーできているか」が重要です。5〜20ファイルでも、それが問い合わせの多い領域なら効果は体感できます。
Q. 既存のチャットボットとどう違うのですか?
従来のチャットボットは事前に「シナリオ」を設計する必要があり、想定外の質問には対応できません。セマンティック検索を使ったAI検索はドキュメントの内容を直接参照するため、シナリオ設計が不要で、幅広い質問に対応できます。詳しくは他サービスとの比較ページをご覧ください。
Q. 社内文書をクラウドに置くのが不安です。
データの暗号化、アクセス制御、組織単位でのデータ分離が標準で実装されているかを確認してください。ものしりAIの対応範囲はセキュリティページに記載しています。
Q. コストはどれくらいかかりますか?
月額制のサービスが主流です。まず無料プランで本記事のチュートリアルを試し、効果を確認してから有料プランを検討するのが確実です。具体的な料金は料金プランページで確認できます。
まとめ
本記事では、セマンティック検索の仕組みと、社内文書で実際に試すまでの手順を解説しました。
- セマンティック検索とは: 文字の一致ではなく、文章の「意味の近さ」で情報を探す検索技術
- 仕組み: 意味を数値に変換し、質問との近さを測り、その根拠をもとに回答する
- キーワード検索との使い分け: 型番や条文番号はキーワード検索、「こういう内容」はセマンティック検索
- 試し方: 文書5〜20件とテスト質問10問を用意し、投入・質問・記録・修正を1周する
- 外れたときに直すのは文書側: 旧版の削除、フォルダ分け、要約の追記で大半は改善する
- 2026年の論点: ベクトル検索を使うかではなく、AIに社内文書をどう見せるか
社内文書が「あるのに見つからない」状態は、日々の生産性を静かに蝕んでいます。まずは問い合わせの多いテーマ1つで、探す時間が本当に減るかどうかを確かめてみてください。
関連記事
この記事をシェア
関連記事
STUDIOにチャットボットを設置する方法|カスタムコードで埋め込む手順【2026年版】
STUDIOで作ったサイトにAIチャットボットを設置する手順を、カスタムコードの実際の画面に沿って解説します。有料プランが必要な理由、プレビューで出ない仕様、埋め込みボックスを使ってはいけない理由まで扱います。
Wixにチャットボットを設置する方法|カスタムコードで埋め込む手順【2026年版】
WixのサイトにAIチャットボットを設置する手順を、ダッシュボードのカスタムコード画面に沿って解説します。ドメイン接続が前提になる理由、ドメイン変更でコードが消える仕様、標準チャットとの違いまで扱います。
Shopifyにチャットボットを設置する方法|アプリ不要のカスタムLiquid手順【2026年版】
Shopifyストアにチャットボットを設置する3つの方法を比較し、アプリ不要のカスタムLiquidでの手順を解説します。テーマ変更で消える問題、チェックアウトに出ない仕様、無料でどこまでできるかまで扱います。